
0. 쿠폰 100장은 나갔는데, 받은 사람은 88명?
문제는 단순해 보였습니다. 쿠폰 100장을 먼저 온 순서대로, 한 사람에게 한 장씩 나눠 주는 것.
이벤트가 끝난 뒤 결과를 확인했습니다. 발급 건수는 정확히 100건입니다. 한 장도 더 나가지 않았습니다.
그런데 당첨자 명단에는 88명만 있었습니다.
열두 명이 두 장씩 가져갔다는 뜻입니다. 그만큼 못 받은 사람도 생겼습니다. 고객센터 문의가 들어오기 시작하고, 그제야 코드를 다시 열어 봅니다.
// 이미 받은 사람인가
if (redis.sismember("coupon:winners", userId)) {
    return 이미참여;
}

// 수량이 남았는가
long n = redis.incr("coupon:count");
if (n > LIMIT) {
    return 마감;
}

redis.sadd("coupon:winners", userId);
return 발급;
코드만 보면 이상한 곳이 잘 보이지 않습니다.
coupon:count에는 지금까지 발급했다고 센 장수가 들어 있고, coupon:winners에는 쿠폰을 받아 간 사용자 ID가 들어 있습니다.
이 코드는 이렇게 동작합니다.
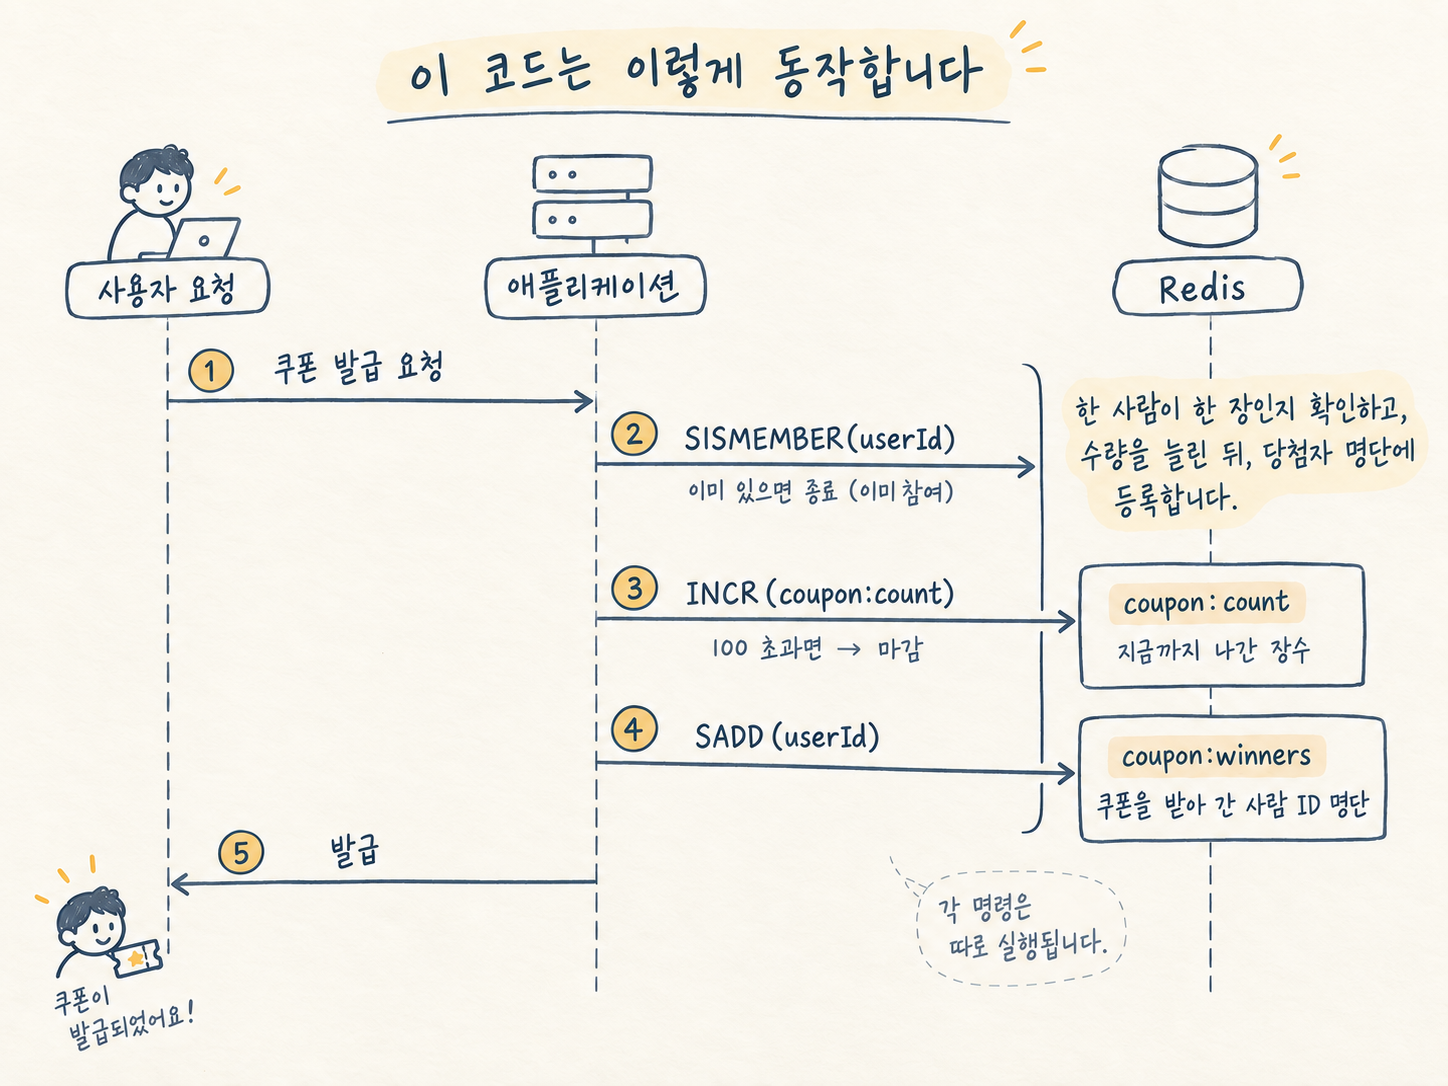
SISMEMBER로 이 사용자가 이미 명단에 있는지 확인합니다.- 없으면
INCR로 카운터를 하나 올립니다. - 100을 넘지 않았으면
SADD로 사용자를 당첨자 명단에 넣습니다. - 마지막으로 발급 성공을 돌려줍니다.
한 사람 한 장도 있고 선착순 100장도 있습니다. 코드 리뷰도 통과했고, 배포 전 동시성 테스트도 통과했습니다.
그런데 결과는 100장, 88명이었습니다.
이 글은 저 코드가 어디에서 깨지는지, 그리고 왜 테스트까지 초록이었는지를 하나씩 따라가 본 기록입니다.
이전 글에서는 같은 조건을 MySQL의 유니크 제약과 조건부 갱신으로 지키는 방법을 다뤘습니다. 이번에는 카운터를 Redis로 옮겼을 때 생기는 문제를 봅니다.
1. 테스트 코드 한 줄을 바꾸자 30번 모두 실패했습니다
가장 이상한 건 이것이었습니다.
이 정도 문제라면 동시성 테스트에서 잡혔어야 하지 않을까?
테스트는 실제로 있었습니다.
@Test
void 동시에_260명이_요청해도_100장만_나간다() throws Exception {
    var 출발 = new CountDownLatch(1);
    var 도착 = new CountDownLatch(260);
    var 발급 = new AtomicInteger();

    for (int i = 0; i < 260; i++) {
        String userId = "user-" + i;

        Thread.ofVirtual().start(() -> {
            출발.await();
            if (쿠폰발급(userId)) {
                발급.incrementAndGet();
            }
            도착.countDown();
        });
    }

    출발.countDown();
    도착.await();

    assertThat(발급.get()).isEqualTo(100);
}
260개의 요청을 같은 시점에 출발시킵니다. 겉으로 보면 꽤 강한 동시성 테스트처럼 보이고, 실제로 이 테스트는 계속 통과했습니다.
그런데 테스트 데이터를 다시 보니 한 줄이 눈에 걸렸습니다.
String userId = "user-" + i;
i는 0부터 259까지 갑니다. 260개 요청이 전부 다른 사용자입니다.
user-0
user-1
user-2
...
user-259
이 부하에서는 같은 사용자의 요청 두 개가 겹칠 일이 애초에 없습니다. SISMEMBER와 SADD 사이가 아무리 벌어져 있어도, 그 틈으로 같은 userId가 들어오지 않습니다.
그래서 한 줄만 바꿔 봤습니다.
String userId = "user-" + (i % 200);
요청은 여전히 260건입니다. 대신 사용자는 200명이고, 그중 60명은 같은 ID로 한 번 더 요청합니다.
검증도 하나 더 붙였습니다.
assertThat(발급.get()).isEqualTo(100);
assertThat(당첨자_명단_크기()).isEqualTo(100);
같은 구현을 두 부하로 각각 30회씩 돌렸습니다.
| 테스트 | 부하 | 결과 |
|---|---|---|
| 테스트 1 | 서로 다른 사용자 260명이 동시에 요청 | 30회 중 30회 통과 |
| 테스트 2 | 사용자 200명, 그중 60명이 한 번 더 요청 | 30회 중 30회 실패 |
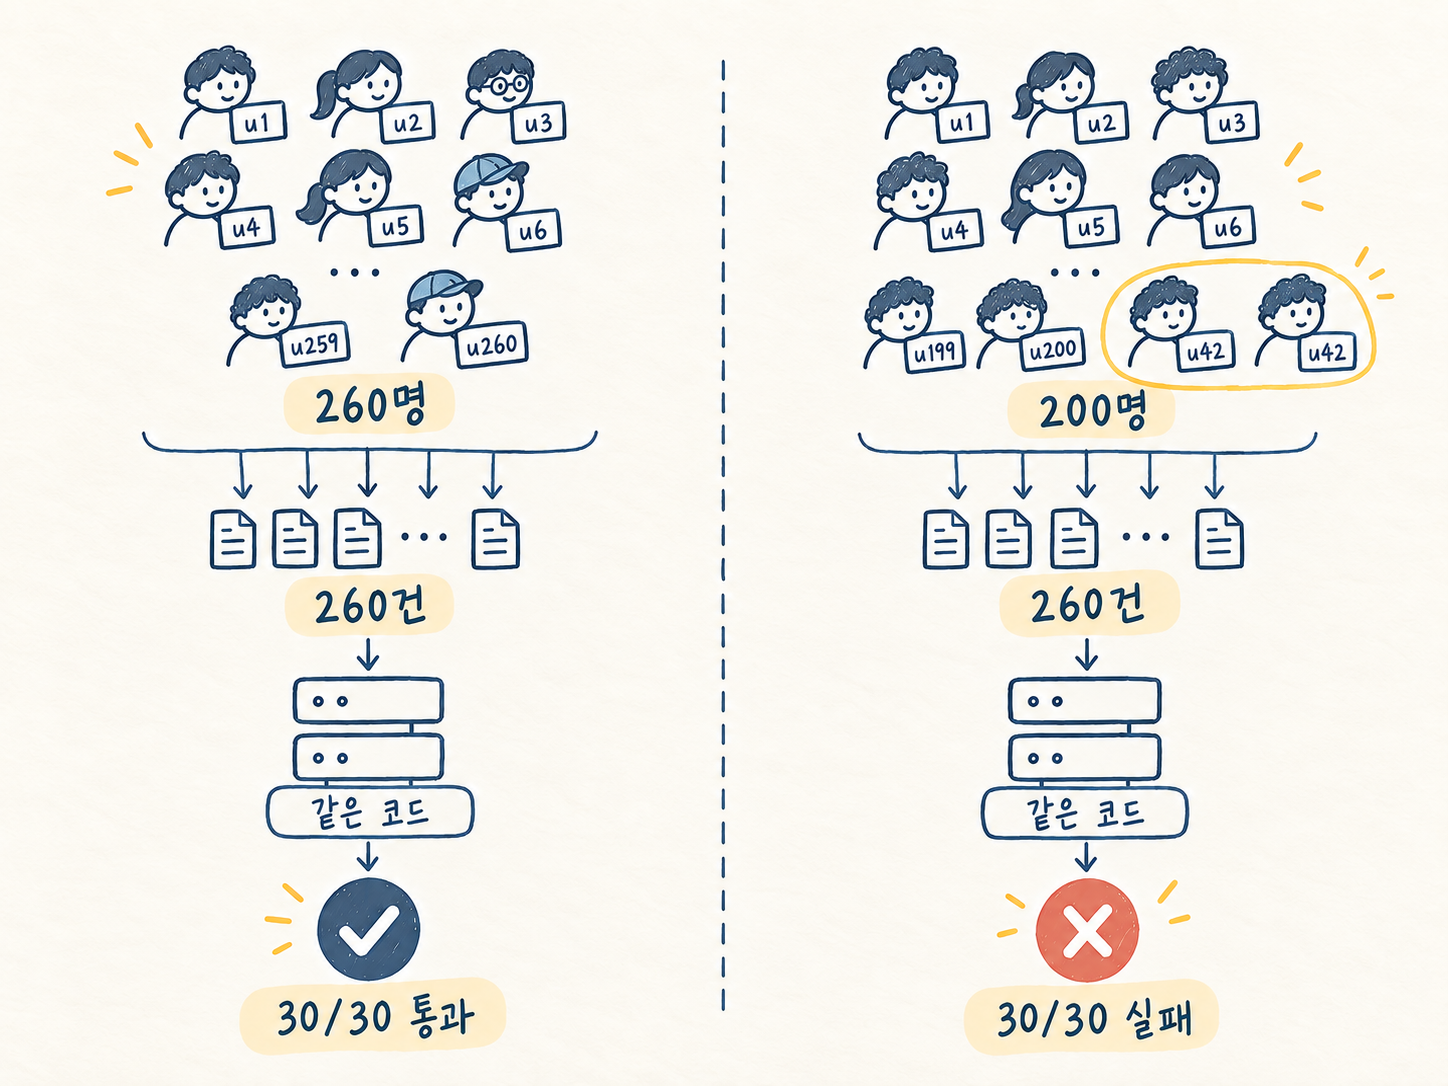
코드는 한 글자도 바꾸지 않았습니다.
"user-" + i

        ↓

"user-" + (i % 200)
달라진 건 어떤 요청들이 서로 경쟁하게 만들었느냐뿐입니다.
첫 번째 테스트는 260개의 서로 다른 사용자가 쿠폰 100장을 놓고 경쟁합니다. 수량 경쟁은 만들지만, 같은 사용자에 대한 경쟁은 없습니다.
두 번째 테스트는 거기에 같은 사용자의 요청까지 겹치게 만듭니다. 그리고 이 코드의 버그는 바로 그때 나타났습니다.
동시에 많이 때렸다는 사실보다, 어떤 값이 서로 경쟁하도록 만들었는지가 더 중요했습니다.
이제 테스트가 무엇을 놓쳤는지는 알았습니다. 다음은 코드가 정확히 어디에서 깨지는지 볼 차례입니다.
2. 중복을 막았더니 이번에는 100장이 다 안 나갔습니다
처음 코드에서 가장 먼저 보이는 문제는 이 부분입니다.
if (redis.sismember("coupon:winners", userId)) {
    return 이미참여;
}
SISMEMBER는 지금 명단에 있는지를 조회할 뿐입니다. 조회한 뒤 실제로 등록하는 SADD까지는 시간이 남습니다.
같은 사용자 u42의 요청 두 개가 거의 동시에 들어오면 둘 다 이렇게 볼 수 있는 것이죠.
요청 A                         요청 B

SISMEMBER u42 -> 없음
                               SISMEMBER u42 -> 없음

...                            ...

SADD u42
                               SADD u42
A가 등록되기 전에 B도 조회를 끝내면, 둘 다 “아직 없는 사람”이라고 판단합니다.
Redis에서는 SADD의 반환값을 이용하면 이 부분은 더 단순하게 만들 수 있습니다.
SADD coupon:winners u42 -> 1   // 처음 들어온 사용자
SADD coupon:winners u42 -> 0   // 이미 있던 사용자
그렇다면 기존의 코드인 이것을
확인
 ↓
등록
이렇게, SADD의 반환값을 사용해 등록을 시도하는 순간 처음인지까지 판단하는 방식으로 변경할 수 있습니다.
등록 시도
   ↓
1이면 처음 / 0이면 중복
long n = redis.incr("coupon:count");
if (n > LIMIT) {
return 마감;
}
long added = redis.sadd("coupon:winners", userId);
if (added == 0) {
return 이미참여;
}
return 발급;
같은 사용자가 다시 요청하면 SADD가 0을 돌려주므로 두 번째 쿠폰은 발급되지 않습니다.
그럼 1장에서 만든 부하로 다시 돌려봅니다.
- 쿠폰 100장
- 사용자 200명
- 그중 60명은 같은 ID로 한 번 더 요청
- 총 요청 260건
- 30회 반복
결과가 이렇게 나왔습니다.
| 구현 | 발급 | 사람 | 두 장 이상 |
|---|---|---|---|
| 처음 코드 | 100 | 88.9 (85~93) | 11.1 |
SADD 결과로 중복을 막은 코드 |
88.4 (85~93) | 88.4 | 0 |
두 장 받은 사람은 사라졌습니다.
그런데 이번에는 100장을 준비했는데 평균 88.4장만 나갔습니다.
중복은 막았는데 쿠폰이 남았습니다.
왜 그럴까요 ? 이미 쿠폰을 받은 u42가 다시 요청했고, 현재 카운터가 56이라고 해보겠습니다.
coupon:count = 56
코드는 먼저 INCR을 실행합니다.
INCR coupon:count
56 -> 57
그다음 SADD를 실행합니다.
SADD coupon:winners u42 -> 0
u42는 이미 당첨자이므로 이번 요청에는 쿠폰을 주지 않습니다. 하지만 카운터는 이미 57이 됐습니다.
카운터        57
실제 새 발급   56
쿠폰은 주지 않았는데 한 장을 쓴 것처럼 숫자만 올라간 겁니다.
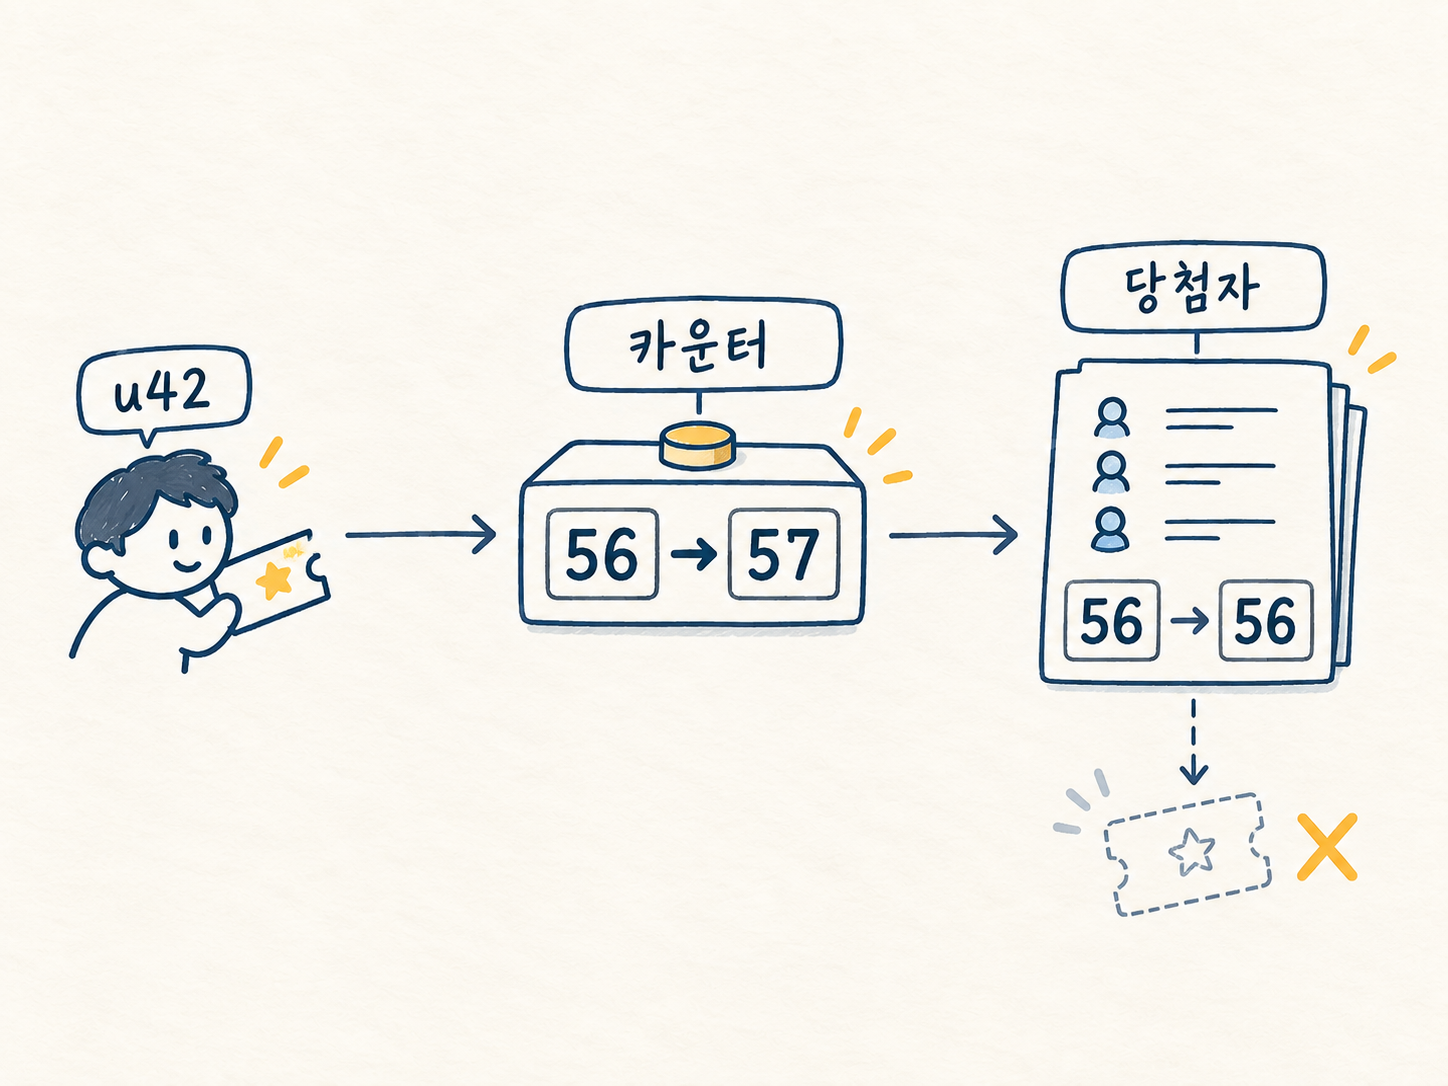
이게 반복되면 카운터가 실제 발급보다 먼저 100에 도달합니다. 시스템은 마감이라고 판단하지만 실제 당첨자는 아직 100명이 아닙니다.
그렇다면 이제 조금 문제가 선명해지는 듯 합니다.
coupon:count    = INCR까지 도달한 요청 수
coupon:winners  = 실제로 등록된 서로 다른 사용자
우리가 알고 싶은 것은 “실제로 쿠폰을 받은 사람 수”인데, INCR은 “여기까지 들어온 요청 수”를 세고 있다는 사실이 보입니다.
같은 사용자의 재요청이 없을 때는 두 숫자가 같지만, 재요청이 생기는 순간 다르게 나타납니다.
u42 첫 요청  -> count +1 / 사람 +1
u42 재요청   -> count +1 / 사람 +0
즉, 카운터가 틀린 게 아니라, 우리가 원하는 것과 다른 것을 정확하게 세고 있는 것이 문제였네요.
3. 명령 하나는 안전했지만, 판단 전체는 안전하지 않았습니다
처음 코드를 다시 보면 애플리케이션에서는 한 덩어리처럼 보이는데,
if (redis.sismember("coupon:winners", userId)) {
    return 이미참여;
}

long n = redis.incr("coupon:count");
if (n > LIMIT) {
    return 마감;
}

redis.sadd("coupon:winners", userId);
return 발급;
사실 Redis 입장에서는 세 번의 별도 명령이죠.
[1] SISMEMBER coupon:winners u42
[2] INCR      coupon:count
[3] SADD      coupon:winners u42
그래서 두 요청은 이렇게 섞일 수 있습니다.
요청 A                              요청 B

SISMEMBER u42 -> 0
                                    SISMEMBER u42 -> 0

INCR -> 57
                                    INCR -> 58

SADD u42 -> 1
                                    SADD u42 -> 0

return 발급
                                    return 발급
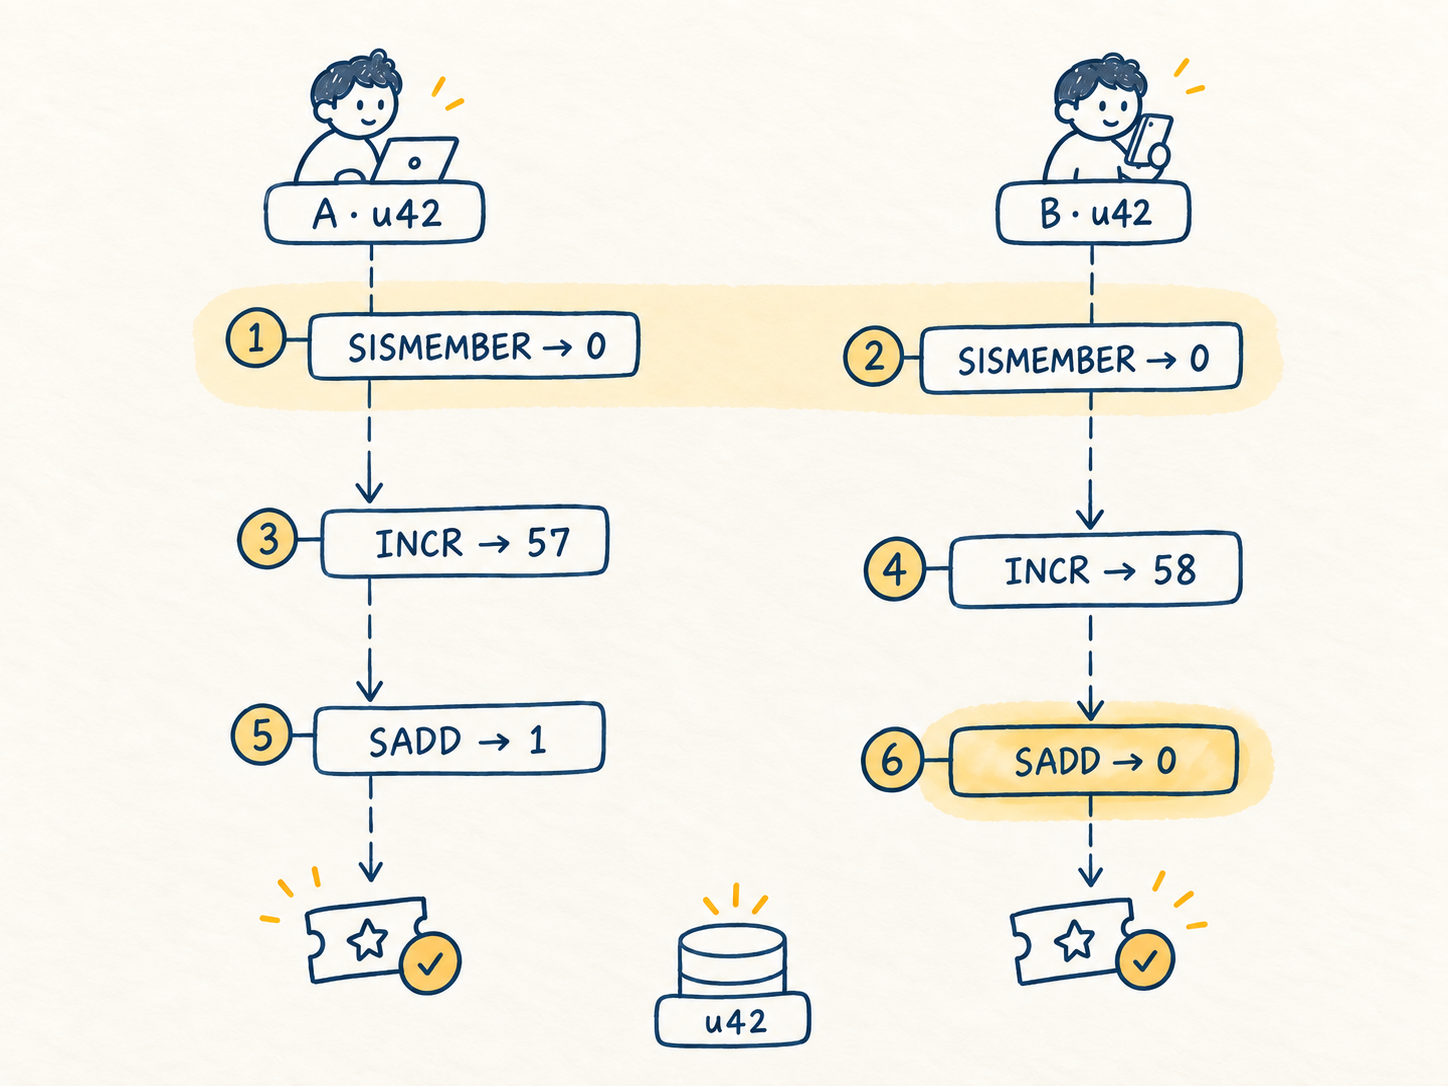
여기서 중요한 건 두 번째 SADD가 이미 0을 돌려주고 있다는 점입니다. Set 자체는 u42를 두 번 저장하지 않았습니다.
문제는 처음 코드가 그 반환값을 보지 않고 바로 발급을 돌려준다는 데 있습니다.
redis.sadd("coupon:winners", userId);
return 발급;
그래서 처음의 100장, 88명이 만들어집니다.
카운터는 A와 B를 모두 셈           -> 2
Set에는 u42가 한 번만 남음         -> 1명
애플리케이션은 A와 B를 모두 성공 처리 -> 2회 발급
이 지점에서 헷갈리기 쉬운 세 가지를 짧게 정리해보려고 합니다.
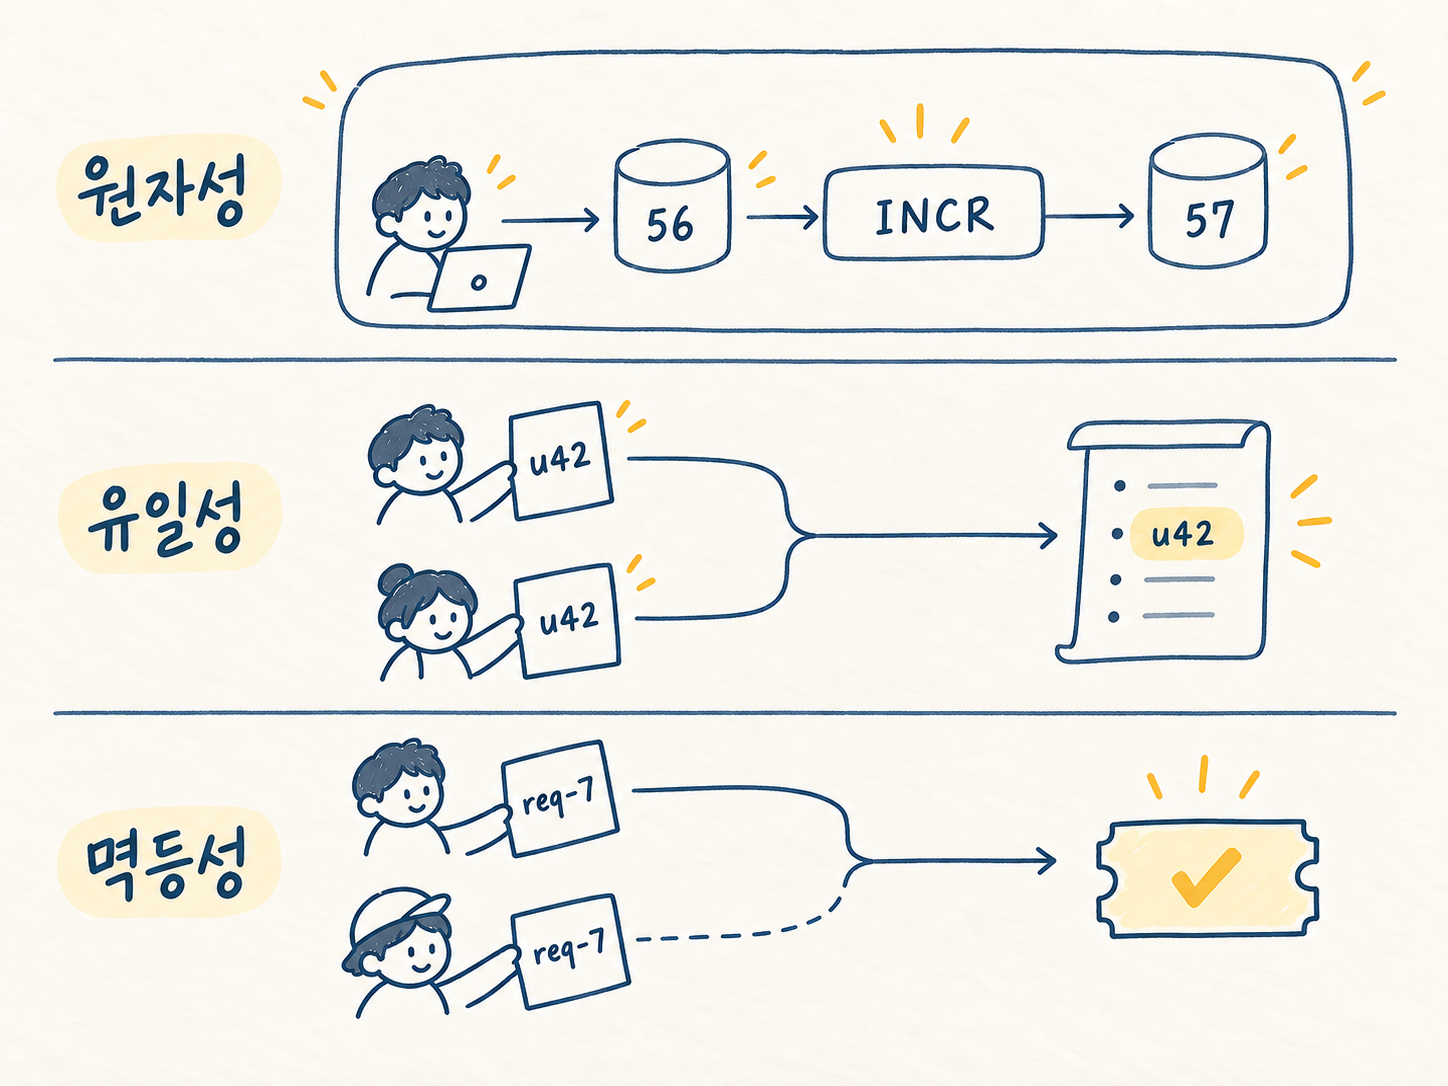
- 원자성:
INCR하나가 중간에 쪼개지지 않는가. - 유일성: 같은
(event_id, user_id)나 같은 Set 원소가 두 번 존재하지 않는가. - 멱등성: 같은
request_id의 재실행이 한 번 실행한 것과 같은 결과를 만드는가.
INCR은 원자적입니다. 그래서 두 요청이 동시에 56을 읽고 둘 다 57을 덮어쓰는 lost update는 생기지 않습니다.
INCR -> 57
INCR -> 58
문제는 명령 하나의 원자성이 SISMEMBER → INCR → SADD라는 비즈니스 판단 전체의 원자성을 만들어 주지는 않는다는 점입니다.
그럼 실패한 뒤 카운터를 DECR로 되돌리면 될까요?
long n = redis.incr("coupon:count");

if (redis.sadd("coupon:winners", userId) == 0) {
    redis.decr("coupon:count");
    return 이미참여;
}
이 경우에도 INCR과 DECR 사이에는 실제 발급보다 큰 카운터가 잠시 존재합니다. 그 사이 다른 요청이 그 숫자로 마감을 판단할 수 있습니다.
INCR
  ↓
잘못 큰 카운터가 잠시 노출
  ↓
SADD 결과 확인
  ↓
DECR
MULTI/EXEC로 묶으면 명령 사이에 다른 클라이언트가 끼어드는 것은 막을 수 있습니다. 하지만 이번 로직에 필요한 건 첫 번째 결과를 보고 뒤 명령을 실행할지 말지 결정하는 분기입니다.
> MULTI
OK
> SISMEMBER coupon:winners u42
QUEUED
> INCR coupon:count
QUEUED
> SADD coupon:winners u42
QUEUED
> EXEC
1) (integer) 1
2) (integer) 58
3) (integer) 0
SISMEMBER의 실제 결과를 알게 되는 시점에는 뒤 명령도 이미 실행된 뒤입니다.
그리고 Redis의 MULTI/EXEC는 관계형 데이터베이스처럼 실행 중 오류가 났다고 앞의 성공한 명령을 자동 롤백하지도 않습니다.
이 글에서 필요한 건 결국 이것입니다.
중복인지 확인한다
수량이 남았는지 확인한다
둘 다 괜찮을 때만 등록한다
판단과 변경 사이에 다른 요청이 끼어들 수 없는 경계가 필요했습니다.
4. 두 상태를 하나로 줄이고, 판단과 변경을 한 번에 끝냈습니다
그러면 순서만 바꾸면 해결될 수 있지 않을까요 ?
if (redis.sadd("coupon:winners", userId) == 0) {
    return 이미참여;
}

long n = redis.incr("coupon:count");
if (n > LIMIT) {
    return 마감;
}

return 발급;
이 구현은 같은 부하에서 일단 표면상 맞는 수치를 보여줍니다.
발급 100
사람 100
두 장 이상 0
그런데 실행이 끝난 뒤 Redis를 보면 이렇습니다.
실제 발급      100
SCARD winners  200
GET count      200
쿠폰이 이미 100장 다 나간 뒤에도 새 사용자는 먼저 SADD를 통과합니다.
SADD user-151 -> 1
INCR          -> 151
151 > 100     -> 마감
쿠폰은 못 받았는데 winners에는 들어가 버립니다.
카운터 먼저  -> 실패한 요청이 수량을 먹음
명단 먼저    -> 실패한 요청이 명단을 오염시킴
따라서, 문제는 순서가 아니라, 함께 맞아야 하는 상태를 둘로 나눠 놓았다는 것, 그것을 고쳐야 합니다.
여기서 상태 자체를 바꿨습니다.
실제 당첨자만 coupon:winners에 들어간다면, 그 Set의 크기가 곧 발급 수량입니다.
SCARD coupon:winners
        =
실제 발급된 서로 다른 사용자 수
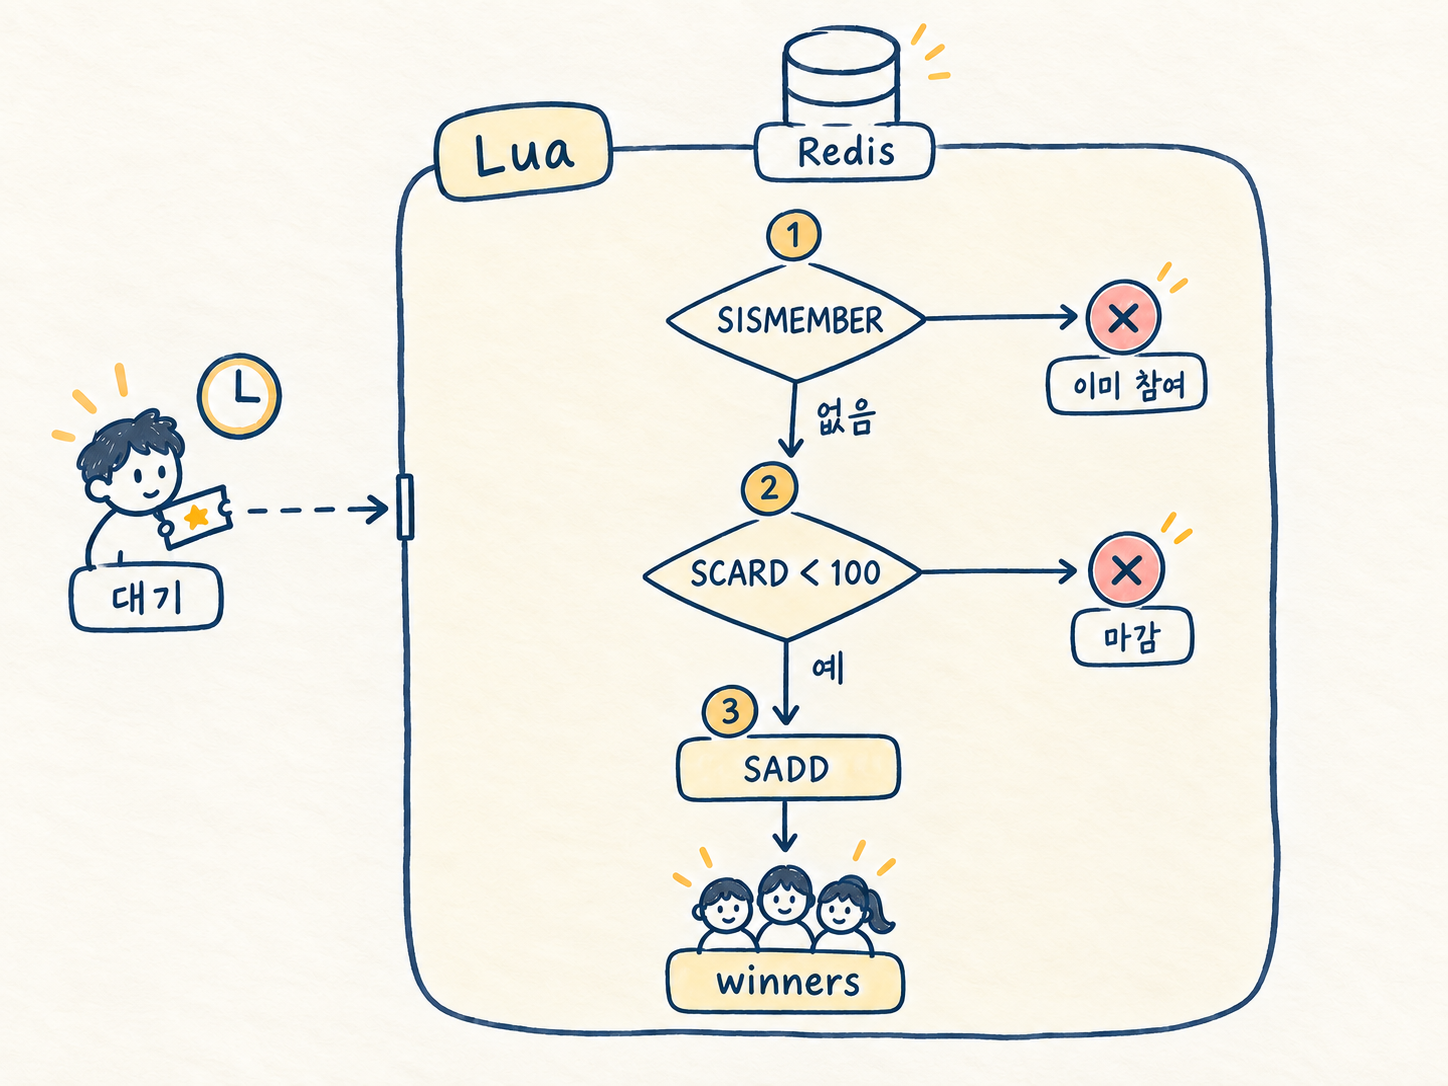
별도의 coupon:count를 없애고, 아래 세 가지를 Redis 안에서 한 번에 판단합니다.
1. 이 사용자가 이미 받았는가?
2. 아직 100명 미만인가?
3. 둘 다 괜찮으면 명단에 넣는다
Lua로 쓰면 이렇게 됩니다.
if redis.call('SISMEMBER', KEYS[1], ARGV[1]) == 1 then
    return -1                                     -- 이미 참여
end

if redis.call('SCARD', KEYS[1]) >= tonumber(ARGV[2]) then
    return -2                                     -- 마감
end

redis.call('SADD', KEYS[1], ARGV[1])
return redis.call('SCARD', KEYS[1])              -- 몇 번째인지
앞에서 SISMEMBER가 문제였는데 여기서는 다시 등장합니다. 명령 자체가 문제였던 게 아니기 때문입니다. 애플리케이션에서 따로 보내면 사이에 틈이 생깁니다.
SISMEMBER
   ↓ 네트워크 왕복
SCARD
   ↓ 네트워크 왕복
SADD
Lua 안에서는 세 단계가 하나의 실행 단위로 처리됩니다.
SISMEMBER
SCARD
SADD
그 사이에 다른 클라이언트의 명령이 끼어들지 않습니다.
지금까지의 구현을 같은 부하로 비교했습니다.
| 구분 | 구현 |
|---|---|
| A | INCR로 수량만 센다 |
| B | SISMEMBER → INCR → SADD |
| C | INCR 후 SADD 결과로 중복을 막는다 |
| E | SADD 후 INCR |
| D | Lua 안에서 중복과 수량을 함께 판단한다 |
각 구현을 돌릴 때마다 Redis 상태를 비우고, 같은 요청 순서가 들어가도록 난수 씨앗을 고정했습니다. 다섯 구현을 한 세트로 돌리고 30회 반복했습니다.
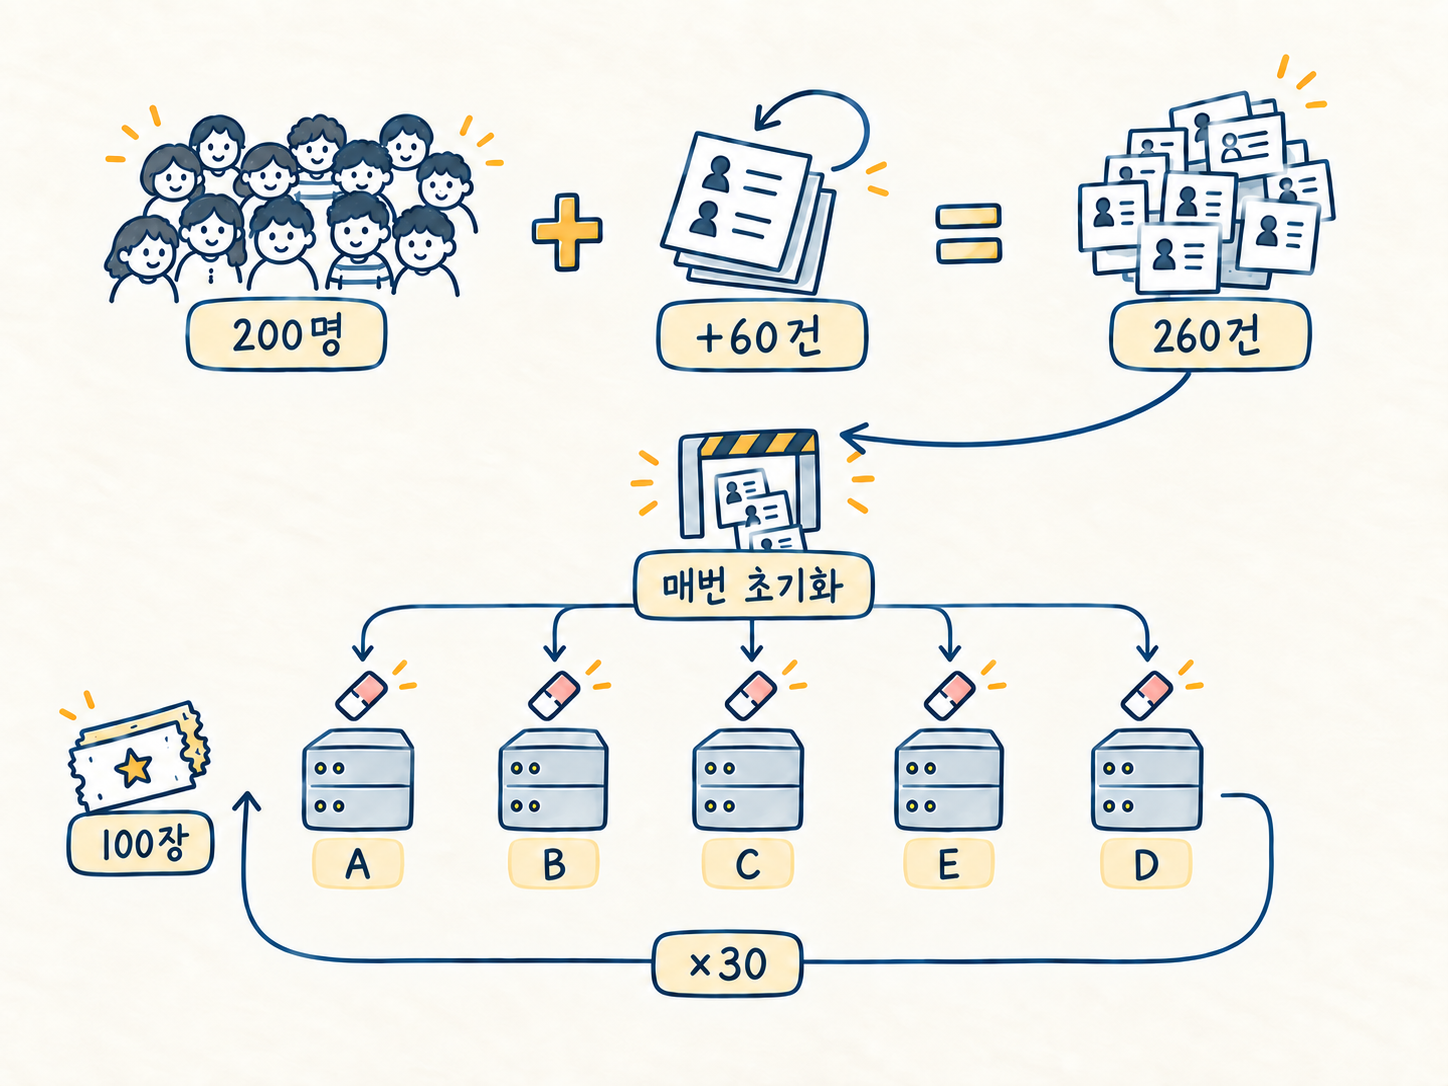
| 구현 | 발급 | 사람 | 두 장 이상 |
|---|---|---|---|
A. INCR로 수량만 센다 |
100 | 87.4 (85~93) | 12.6 (7~15) |
| B. 1인 1매 검사를 넣는다 | 100 | 88.9 (85~93) | 11.1 (7~15) |
| C. 카운터 먼저, 등록 나중 | 88.4 (85~93) | 88.4 | 0 |
| E. 등록 먼저, 카운터 나중 | 100 | 100 | 0 |
| D. 판단과 등록을 한 번에 한다 | 100 | 100 | 0 |
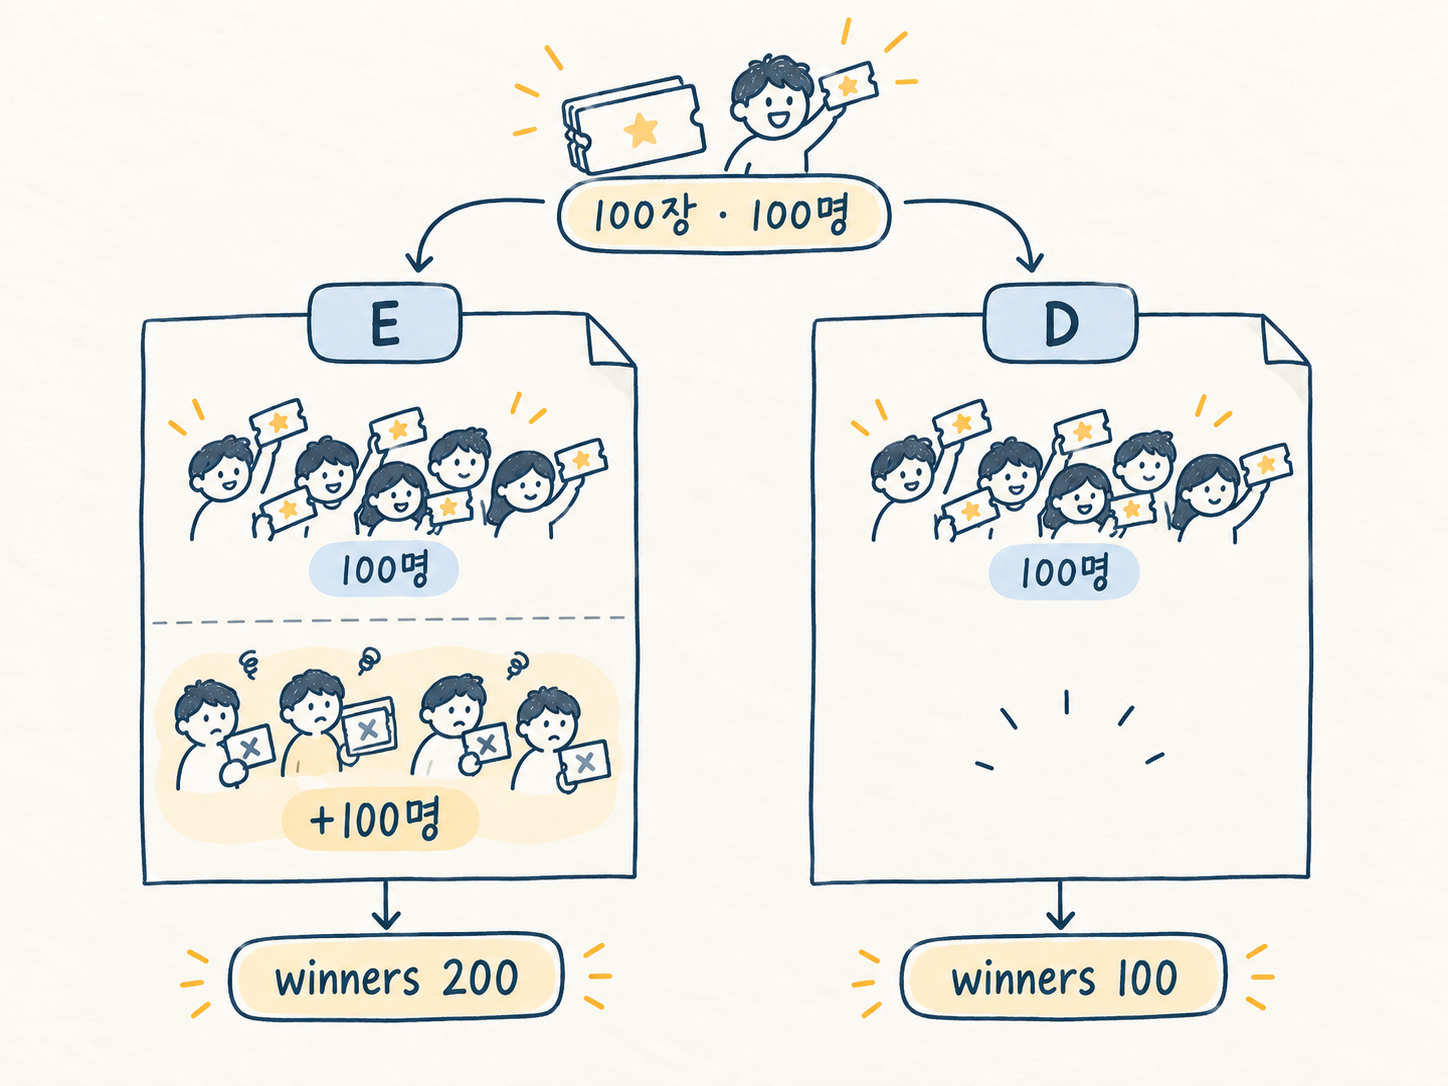
A와 B는 생각보다 차이가 작습니다. 같은 사용자의 두 요청이 겹치면 둘 다 SISMEMBER를 통과할 수 있기 때문입니다. C는 중복은 막았지만 중복 요청이 카운터를 먼저 먹습니다. E와 D는 표만 보면 같습니다. 하지만 내부 상태는 다릅니다.
E: winners 200 / count 200
D: winners 100
E에는 쿠폰을 못 받은 사용자까지 winners에 들어가 있고, D에는 실제 당첨자만 남습니다. 겉으로 보이는 성공 건수뿐 아니라, 실행 뒤 남은 상태까지 맞아야 했습니다.
5. 결국 테스트가 표현해야 했던 것은 ‘동시 요청 수’가 아니었습니다
처음 테스트도 틀린 것은 아니었습니다.
String userId = "user-" + i;
이 테스트는 서로 다른 사용자들이 동시에 수량을 경쟁할 때 100장을 넘지 않는가를 확인합니다. 그 질문에는 잘 답하고 있었습니다. 다만 우리가 실제로 가진 버그는 다른 질문이었습니다.
String userId = "user-" + (i % 200);
같은 사용자의 요청 두 개가 확인과 등록 사이에 겹쳐도 한 번만 반영되는가.
이 질문과 그에 대한 답이 필요했던 것입니다.
고친 Lua 구현 D에 같은 부하를 다시 걸면 30회 모두 다음 결과가 나옵니다.
발급 100
사람 100
두 장 이상 0
이 실험에서 남은 기준은 세 가지로 정리해볼 수 있을 것 같습니다.
무엇을 세려는가
들어온 호출 횟수인가?
실제로 성공한 요청 수인가?
서로 다른 사용자 수인가?
INCR은 호출 횟수를 세는 데는 정확합니다. 하지만 중복을 제거한 당첨자 수를 자동으로 만들어 주지는 않습니다.
무엇이 두 번 존재하면 안 되는가
같은 사용자?
같은 주문?
같은 요청?
event_id + user_id의 유일성과 request_id의 멱등성은 서로 다른 규칙입니다.
어떤 상태가 반드시 같이 바뀌어야 하는가
이번 예제에서는 당첨자 등록과 발급 수량이었습니다. 하나만 성공해도 괜찮은 상태가 아니라면 같은 경계 안에서 처리해야 합니다.
한 데이터베이스 안에서 끝낼 수 있다면 트랜잭션과 유니크 제약이 더 단순할 수 있습니다. Redis 안에서 끝내야 한다면 Lua처럼 판단과 변경을 한 번에 실행하거나, WATCH + MULTI처럼 충돌을 감지하고 재시도하는 방법을 볼 수 있습니다.
이 글에서는 Lua를 골랐지만 핵심은 Lua 그 자체는 아니라고 생각합니다.
각 명령이 원자적이라는 것과 별개로, 여러 명령으로 만든 비즈니스 판단 전체가 원자적임을 어떻게 보장할 수 있느냐죠.
이 패턴은 쿠폰 외 다른 상황에서도 볼 수 있습니다.
쇼피파이는 재고 예약은 Redis에, 실제 재고 원장은 MySQL에 두고 있었습니다. 결제가 완료되면 MySQL의 재고를 차감하면서 Redis의 예약도 정리해야 했는데, 서로 다른 저장소에 있는 두 변경을 하나로 묶을 수 없었습니다.
“those two operations couldn't be wrapped in a single atomic step.”
그래서 순서에 따라 실제 재고는 차감됐는데 예약이 남거나, 그 반대의 상태가 생길 수 있었습니다. 쇼피파이는 결국 예약과 재고 원장을 같은 MySQL로 가져와 하나의 ACID 트랜잭션으로 처리했습니다.
Shopify Engineering — We replaced Redis with MySQL for inventory reservations
아마존의 멱등 API 설계에서도 같은 이야기를 볼 수 있는데요. 같은 요청이 다시 들어왔는지 판단하기 위해 client request identifier를 기록하는 것만으로는 부족합니다. 그 ID를 기록하는 일과 실제 리소스를 변경하는 일이 서로 따로 성공하면 또 다른 불일치가 생기기 때문입니다.
“must meet the properties for an atomic, consistent, isolated, and durable (ACID) operation.”
즉 요청 ID는 기록됐는데 실제 변경은 실패하거나, 실제 변경은 됐는데 요청 ID는 기록되지 않는 상태를 막기 위해 멱등 토큰 기록과 실제 변경을 하나의 원자적 작업으로 묶어야 한다는 설명입니다.
AWS Builders' Library — Making retries safe with idempotent APIs
쿠폰의 coupon:count와 coupon:winners, 쇼피파이의 예약과 재고 원장, 아마존의 요청 ID와 실제 상태 변경은 규모와 형태는 다르지만 결국 같은 질문으로 돌아옵니다.
함께 맞아야 하는 상태를 어디까지 하나의 변경 경계로 묶을 것인가.
그리고 이 실험에도 경계가 하나 남아 있습니다. 여기서 발급은 Redis가 발급 가능하다고 판정한 지점까지입니다. 실제 쿠폰 행을 데이터베이스에 만들고 사용자에게 지급하는 작업까지 Redis와 하나의 트랜잭션으로 묶인 것은 아닙니다. 실제 시스템이라면 데이터베이스 유니크 제약을 마지막 방어선으로 두거나, Redis 판정과 실제 발급 기록을 대조하는 복구 절차를 두거나, 함께 맞아야 하는 상태를 같은 저장소로 가져오는 식으로 다음 경계까지 설계해야 할 것입니다.
다만 이번 실험에서 한번 더 짚어보고 싶은 점은 구현 방법보다 테스트라는 생각을 합니다.
처음 테스트는 이렇게 사용자를 만들었죠.
String userId = "user-" + i;
260개의 요청을 동시에 보냈지만, 260개가 전부 다른 사용자였습니다. 그래서 같은 사용자의 두 요청이 겹쳐야만 드러나는 버그는 한 번도 만들어지지 않았습니다.
그런데 이렇게 바꾸자,
String userId = "user-" + (i % 200);
요청 수는 여전히 260건이었지만, 이제 60건은 같은 사용자의 요청과 겹쳤습니다.
같은 코드는 첫 번째 테스트에서 30번 모두 통과했고, 두 번째 테스트에서는 30번 모두 실패했습니다.
동시성 테스트를 했느냐보다, 어떤 동시성을 만들었느냐가 더 중요했습니다.
재현 코드
이 글의 표와 실행 화면은 아래 코드를 실제로 돌린 결과입니다. Java 파일 하나와 Redis 한 대면 재현할 수 있습니다.
https://github.com/renechoi/duplicate-coupon-lab
docker run -d --name coupon-lab-redis -p 6399:6379 redis:7-alpine
java CouponLab.java
재시도 비율 30퍼센트는 실험을 위해 정한 값입니다. 실제 서비스에서 관측한 비율은 아닙니다. 소스의 RETRY_PCT를 바꾸면 비율을 달리해서 확인할 수 있습니다.
참고 자료
- Redis Transactions:
MULTI/EXEC, 롤백 부재,WATCH + MULTI - SADD: Set에 새 값이 추가됐는지 알려 주는 반환값
- SET:
NX옵션 - Scripting with Lua: Lua 스크립트 실행
- SCARD: Set의 원소 수 확인
- We replaced Redis with MySQL for inventory reservations: 예약 상태와 재고 원장을 같은 트랜잭션 경계로 옮긴 사례
- Making retries safe with idempotent APIs: 요청 ID를 이용한 멱등 API 설계
더 생각해볼 질문들
1. Set 말고 String + SET NX로 하면 되는 것 아닌가요?
됩니다. 한 사람 한 장만 막는다면 오히려 이쪽이 더 직관적일 수 있습니다.
SET coupon:1:user:42 1 NX
처음 온 사용자만 OK를 받고, 같은 사용자의 두 번째 요청은 실패합니다. 그런데 전체 100장이라는 조건은 그럼 어떻게 해야할까요?
보통은 별도의 coupon:count를 두게 되고, 그러면 사용자별 발급 여부와 전체 수량이라는 두 상태를 다시 함께 맞춰야 합니다. 물론 이 둘도 Lua로 한 번에 처리할 수 있으므로 String이 틀린 선택은 아닙니다.
이 글에서 Set을 쓴 이유는 coupon:winners 하나가 중복 없는 당첨자 명단이면서 동시에 SCARD로 현재 발급 인원 수까지 알려 주기 때문입니다. 즉 이 문제에서는 상태를 하나 덜 들고 갈 수 있어서 선택했습니다.
2. 그냥 DB에서 유니크 제약과 수량 차감을 한 트랜잭션으로 처리하면 안 되나요?
됩니다. 그리고 트래픽이 감당되는 규모라면 가장 먼저 검토할 방법이라고 생각합니다.
UNIQUE(event_id, user_id)로 1인 1매를 막고, issued < limit 조건이 붙은 수량 갱신을 같은 트랜잭션 안에 넣으면 됩니다. 중복 삽입이 실패하면 수량 변경도 함께 롤백되므로 Redis에서 봤던 카운터만 올라가고 발급은 실패하는 상태가 생기지 않습니다.
Redis를 끌어오는 이유는 정확성 때문이라기보다 부하를 어디서 받을 것인가에 가깝습니다. 이벤트 오픈 순간 모든 요청이 같은 재고 행을 갱신하면 그 행이 병목이 될 수 있고, 그런 상황에서 Redis를 앞단 판정 계층으로 두는 선택을 할 수 있습니다. 반대로 그 정도 트래픽이 아니라면 저장소를 나누지 않는 편이 더 단순합니다.
3. Lua 말고 WATCH + MULTI나 분산 락을 쓰면 안 되나요?
둘 다 가능합니다. 다만 해결 방식의 성격이 조금 다릅니다.
WATCH + MULTI는 값을 읽은 뒤 누군가 바꾸면 EXEC을 실패시키고 다시 시도하는 낙관적 충돌 처리입니다. 경쟁이 심하지 않다면 충분히 쓸 수 있지만, 같은 키에 요청이 몰리면 충돌과 재시도가 많아질 수 있습니다. 분산 락도 가능하지만 락의 획득·만료·실패 복구까지 새로 관리해야 합니다.
이번 로직은 중복 확인 → 수량 확인 → 등록 정도로 짧고 Redis 안에서 끝나기 때문에 Lua로 한 번에 실행하는 편이 단순했습니다.
다만 Lua도 실행 중에는 Redis를 점유하므로 오래 걸리는 작업을 넣으면 안 됩니다. 핵심은 기능 이름보다 판단과 변경을 어떤 경계 안에서 안전하게 끝낼 것인가입니다.
'Build > 엔지니어링' 카테고리의 다른 글
| 락을 걸었더니 서른 명이 쿠폰을 못 받았습니다: 유니크 제약과 조건부 쓰기가 안에서 하는 일 (1) | 2026.08.08 |
|---|---|
| 직접 쓴 논문 리뷰하기: JPA 성능에 대해 우리가 착각하던 세 가지 (0) | 2026.07.29 |
| 이벤트 드리븐 트러블슈팅 Ep. 5: "결제했는데 상품이 없습니다" — 영수증과 지급 사이의 빈 공간 (0) | 2026.06.06 |
| 이벤트 드리븐 트러블슈팅 Ep. 4: "커밋된 걸까?" — 결제 시스템에서 만난 분산 트랜잭션의 진짜 함정들 (0) | 2026.06.06 |
| 실시간처럼 보이지만, 사실은 뒤에서 작업했어요: Pending URL을 활용한 이미지 업로드 UX 개선기 (2) | 2025.08.30 |